近日,智谱正式推出新一代大模型GLM-5.3-FlashX,官方公布其最高推理输出速度可达200 tokens/s,大幅降低了内容生成的等待时延,为企业级开发者带来了流畅度显著提升的API调用体验。
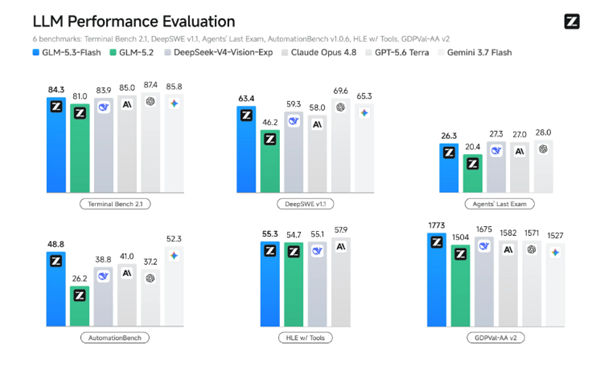
GLM-5.3-FlashX并非从零打造的全新模型,其技术基底正是此前以“Ox Alpha”为名面向全球开发者亮相的GLM-5.3-Flash版本。该模型凭借同参数尺寸下顶尖的智能表现,在海内外开发者圈层积累了良好口碑,平台调用量持续走高。随着市场需求快速攀升,智谱基于已由10万张国产芯片搭建完成的大规模推理算力底座,进一步在底层基础设施建设与全链路推理优化上加大资源投入,最终推出的GLM-5.3-FlashX,首次实现了模型智能水平、调用成本与推理速度三者的协同升级。
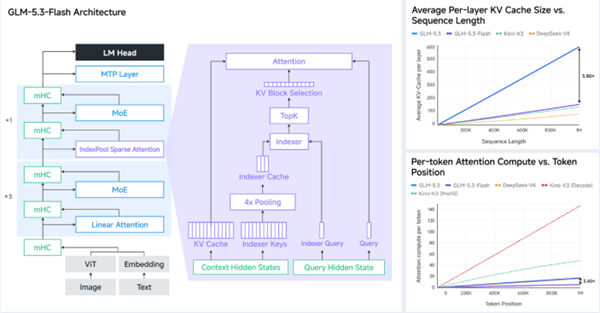
目前,GLM-5.3-FlashX 对应的API接口已正式上线开放,开发者在平台调用时,直接指定模型标识 Model Key 为 GLM-5.3-FlashX 即可完成接入。对于长期受大模型响应卡顿、等待时长久困扰的生产级落地场景而言,每秒200 tokens 的推理速度门槛,代表这款新模型能够在完全保留原有高智能表现的基础上,将生成响应的延迟压缩至流畅轻快的区间,为各类高实时性需求的大模型应用提供了更可靠的落地选择。